Why Tflex
우리 데이터를 잘 아는 모델이 필요한가요?
내부에 직접 모델을 만들어야 한다면, 학습 데이터 생성부터 학습 · 평가 · 배포 · 운영까지 Tflex가 그 전 과정을 지원합니다.
폐쇄망 · 보안 우려
“외부 모델을 쓰자니, 내부 문서가 밖으로 나가는 게 걱정입니다.”
온프레미스 구축
내부 서버에 설치해 문서 · 학습 데이터 · 모델이 외부로 나가지 않습니다.
비용 부담
“API 비용이 쓸수록 늘어나는데, 어디까지 감당해야 할지 모르겠어요.”
자체 운영
직접 학습한 모델을 내부 GPU 자원으로 운영해, 사용량에 따라 늘어나는 API 비용이 없습니다.
내부 데이터 특화 필요
“범용 모델은 우리 업무 용어와 규정을 모릅니다.”
내부 데이터 학습
내부 문서를 올리면 학습 데이터로 변환해 파인튜닝하고, 조직의 규정 · 용어를 반영한 모델을 서비스합니다.
One platform
LLM 개발의 전 과정을 하나의 플랫폼에서
도구를 옮겨 다니지 않고, 단계마다 데이터 소스 · 학습 방식 · 모델을 직접 선택해 조직의 환경과 목적에 맞게 구성합니다.
- 1
데이터
Data
다양한 소스에서 데이터를 수집하고, 가공해 학습에 필요한 데이터셋을 준비합니다.
- 파일 업로드(pdf, hwp 등)
- NAS 등록
- 허깅페이스
- 기존 데이터셋 재선택
- 2
학습
Train
원하는 학습 방식과 세부 기법을 선택해 모델을 학습시킵니다.
- SFT — FFT · LoRA
- Preference — DPO · ORPO · CPO · SimPO 등
- 3
평가
Evaluate
여러 모델을 비교하고, 다양한 벤치마크로 학습 모델의 성능을 검증합니다.
- 단일 모델 평가
- 여러 모델 비교 평가
- Standard · Large-Scale 벤치마크
- 4
배포
Deploy
검증된 모델을 실제 서비스에 적용할 수 있도록 배포합니다.
- 학습한 등록 모델
- 범용 모델 API
- RAG ON / OFF
- 5
운영
Operate
배포된 모델을 안정적으로 운영하고, 사용자와의 연결을 관리합니다.
- MASTER · WORKER 서버 구성
- 전체 GPU / 개별 GPU 할당
01 · From Document to Dataset
문서만 넣으면 학습 데이터로
우리 조직의 문서를 업로드하면 학습 데이터 준비가 끝납니다. 사용할 수 없는 데이터는 학습 전에 걸러냅니다.
- 일반 LLM 구축 도구
- 일반 도구는 이미 만들어진 데이터셋 업로드부터 시작하며, 원문을 학습 데이터로 바꾸려면 별도 도구가 필요합니다.
- Tflex
- PDF · HWP · DOCX 원문을 올리면 QA · COT · PT는 물론 텍스트+이미지(VQA)까지, 프롬프트 수정과 필터링 전처리까지 한 화면에서 처리합니다.
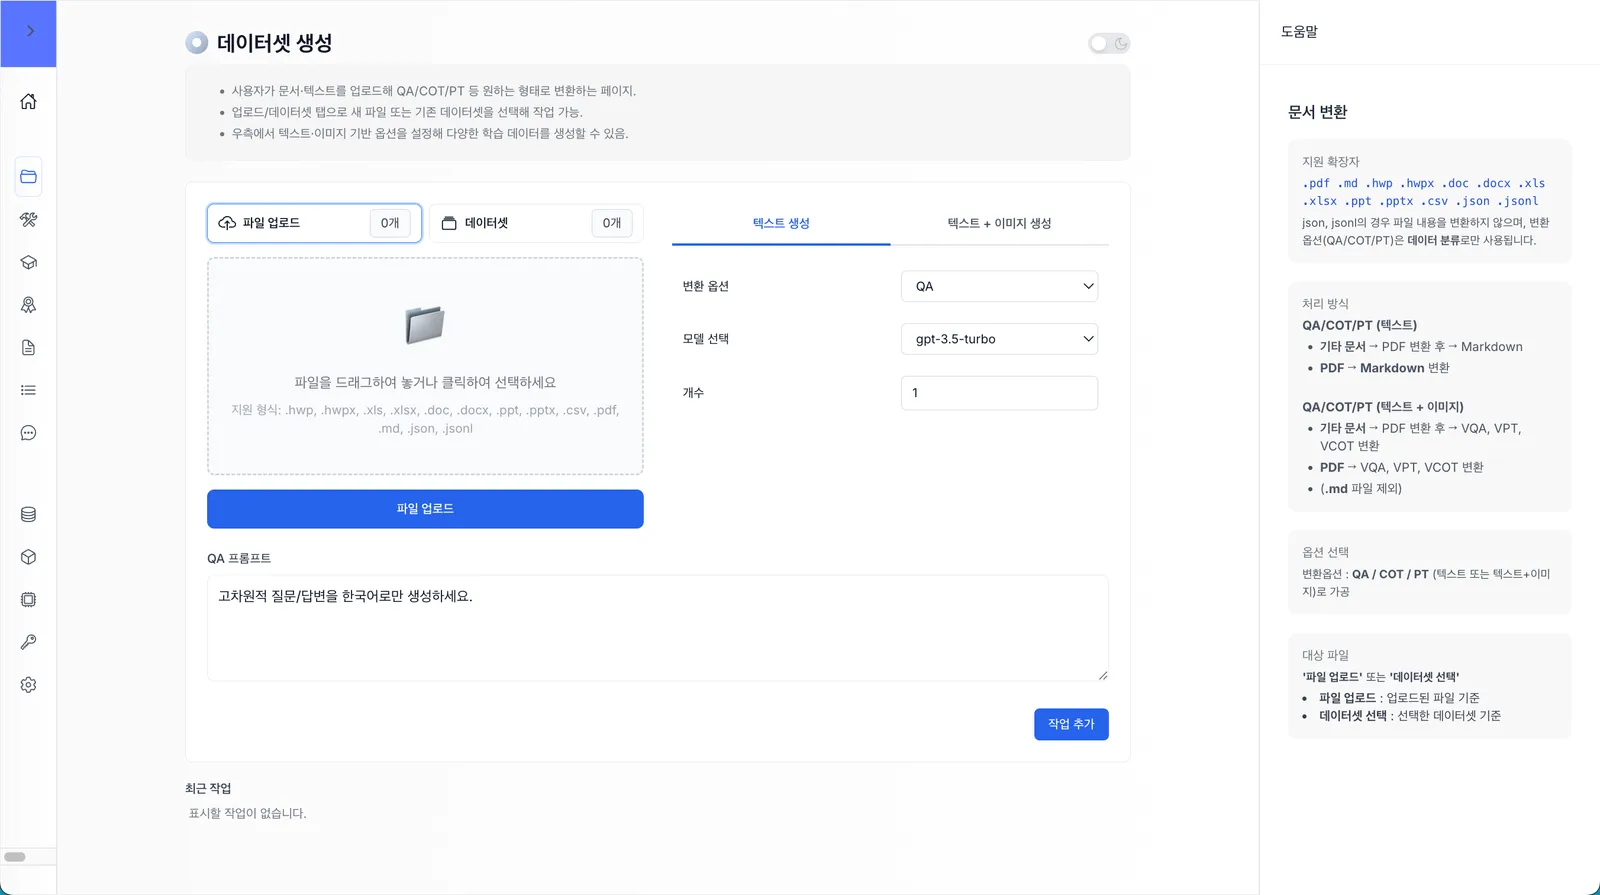
데이터셋 생성 — 문서를 올리고 변환 형식 · 생성 모델 · 프롬프트를 지정합니다. 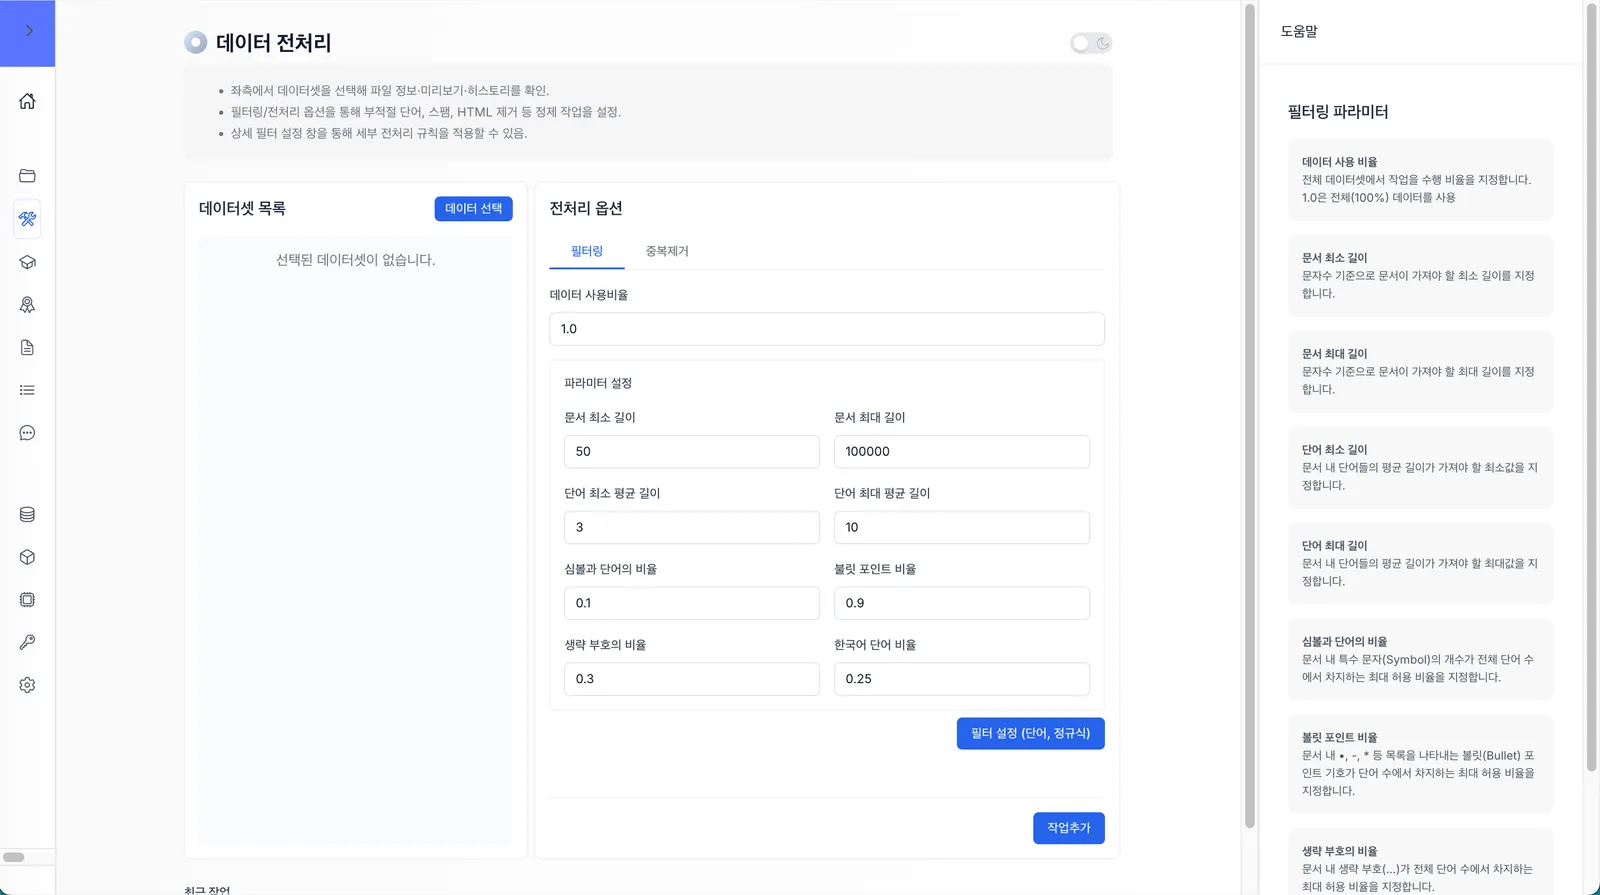
데이터 전처리 — 길이 · 비율 기준과 단어 · 정규식 필터로 학습 데이터를 정제합니다.
- 01
원문 그대로 업로드
hwp · hwpx · docx · pptx · xlsx · pdf 등 업무 문서를 변환 없이 올립니다. 이미 만든 데이터셋을 다시 골라 이어서 작업할 수도 있습니다.
- 02
텍스트 · 이미지 생성 형태 선택
QA · COT · PT 중 목적에 맞는 형식과 생성 모델, 개수를 지정합니다. 사진 · 도표가 포함된 문서는 텍스트+이미지(VQA)로 처리합니다.
- 03
프롬프트 직접 수정
“한국어로만 생성” 같은 생성 지침을 화면에서 바로 편집해, 기관의 문체 · 용어 요구를 데이터 생성 단계부터 반영합니다.
- 04
길이 · 비율 기준 필터링
문서 최소 · 최대 길이, 기호 비율, 한국어 단어 비율 등을 조절해 너무 짧거나 기호투성이인 문장을 자동으로 제외합니다.
- 05
단어 · 정규식 커스텀 필터
부적절한 단어, 스팸 단어, HTML 태그를 목록으로 제거하고 특정 토큰을 치환합니다. 기관 자체 금칙어 기준을 그대로 적용할 수 있습니다.
- 06
중복 제거와 작업 큐
문장 유사도 기준으로 중복을 제거하고, 작업은 큐에 등록되어 순서대로 처리됩니다. 이전 전처리 이력을 이어서 수행할 수도 있습니다.
02 · Train-to-Serve Pipeline
학습한 모델을 바로 챗봇으로
학습 방식을 고르면 순서대로 학습이 진행되고, 평가로 선별한 모델에 지식DB를 붙여 곧바로 서비스합니다.
- 일반 LLM 구축 도구
- 일반 도구는 학습된 모델 파일을 내보내는 데서 끝나며, 실제 서비스를 위해서는 별도 구축이 필요합니다.
- Tflex
- 학습한 모델을 한국어 벤치마크로 검증하고, 지식DB(RAG)를 붙여 바로 챗봇으로 서비스합니다.
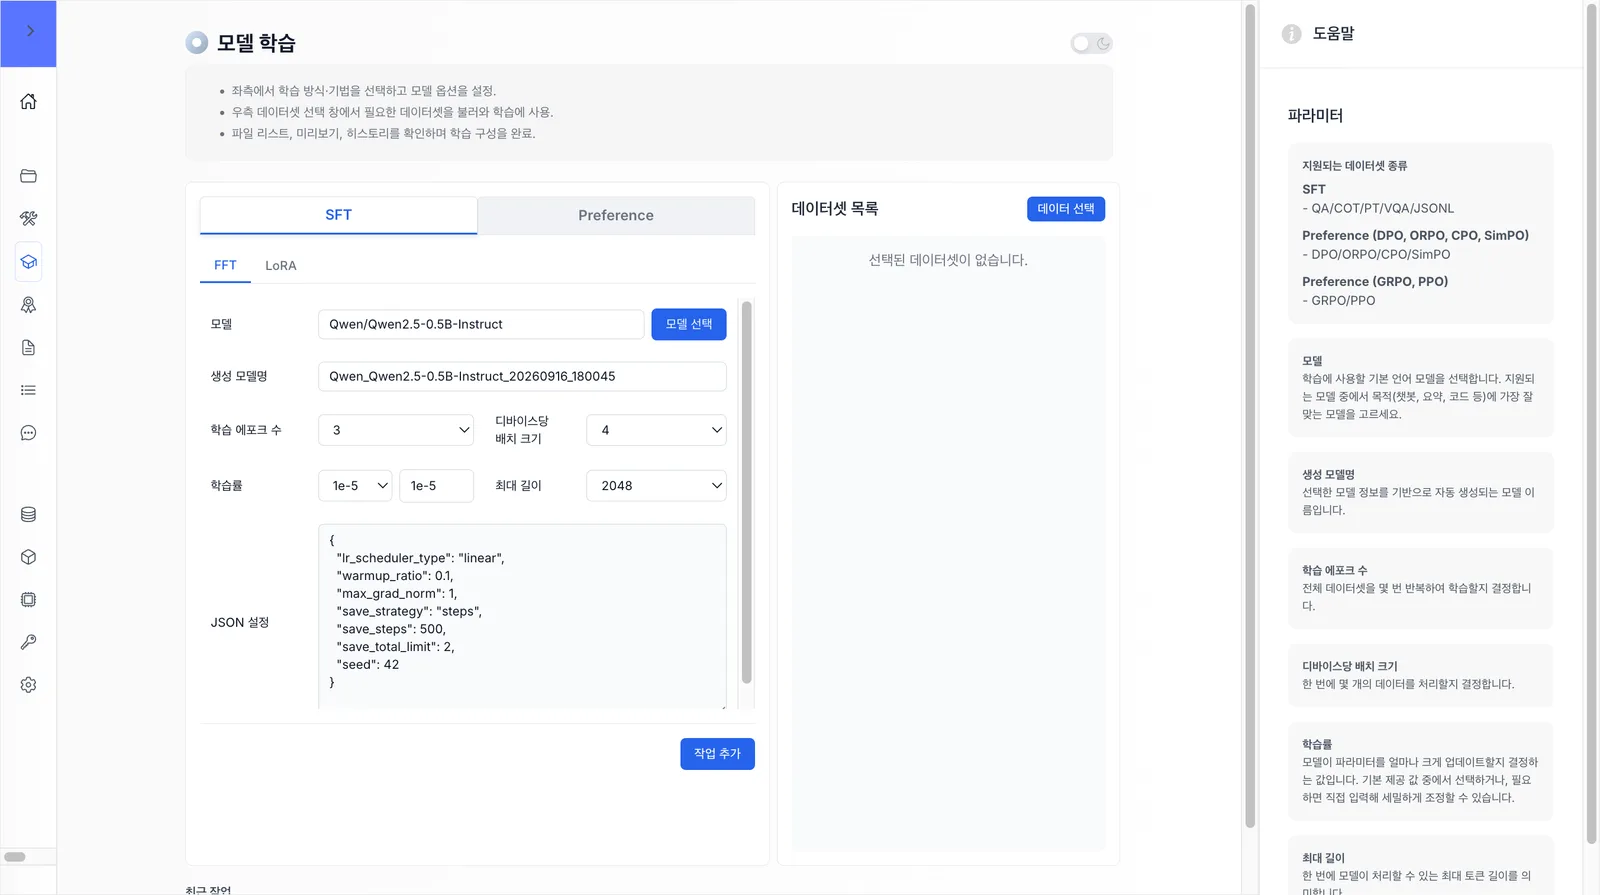
모델 학습 — SFT · Preference 방식과 세부 기법, 학습 파라미터를 화면에서 설정합니다. 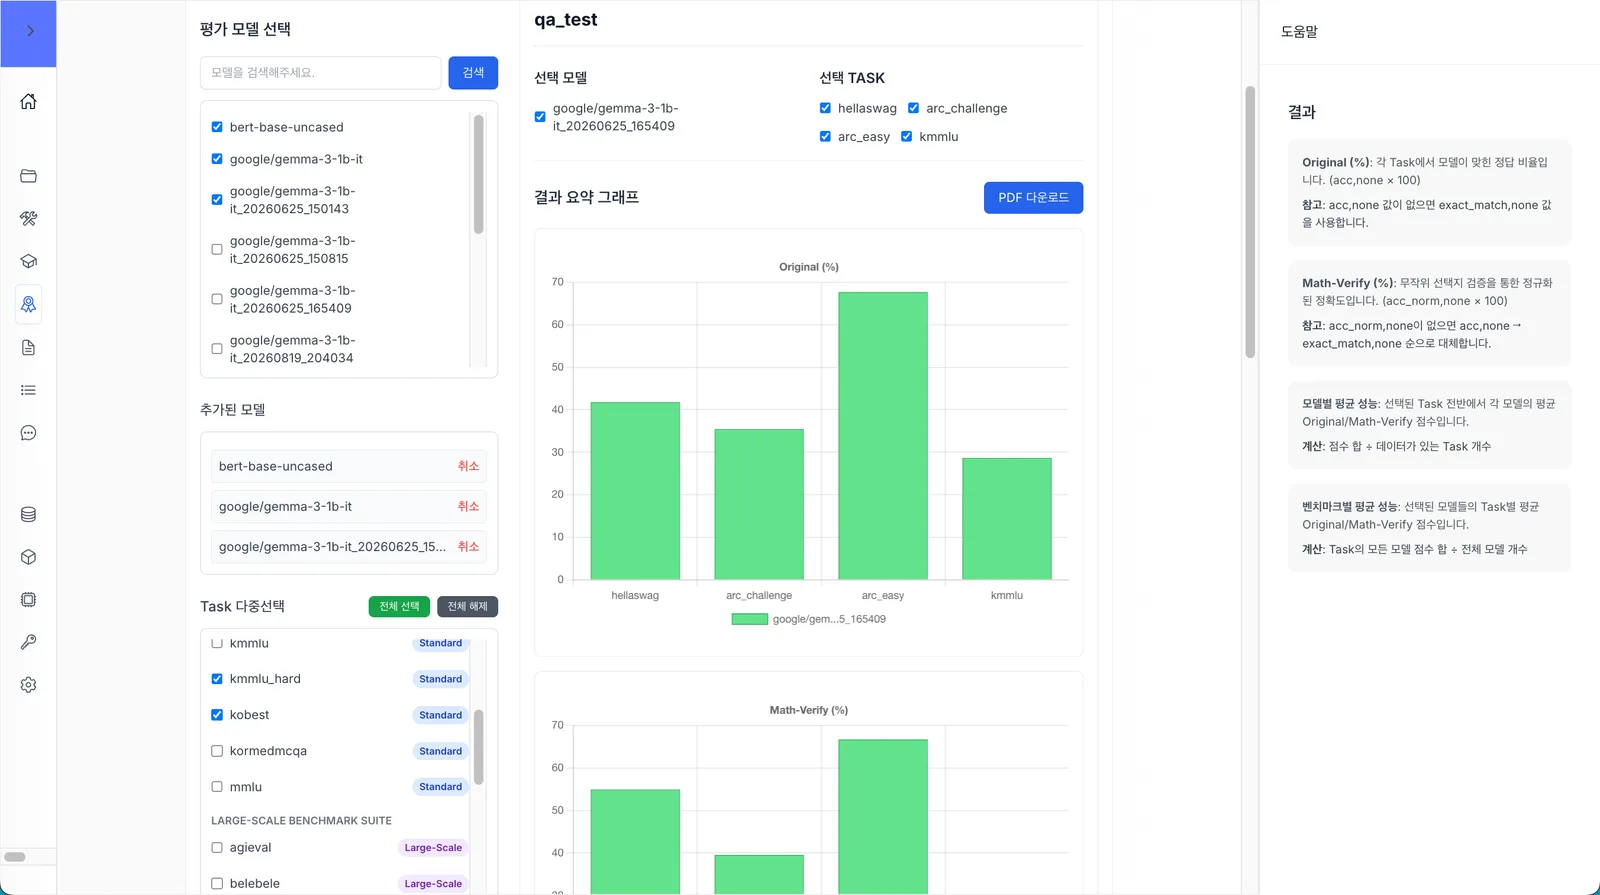
모델 평가 — 여러 모델을 한국어 · 대규모 벤치마크로 비교하고 결과를 그래프로 봅니다. 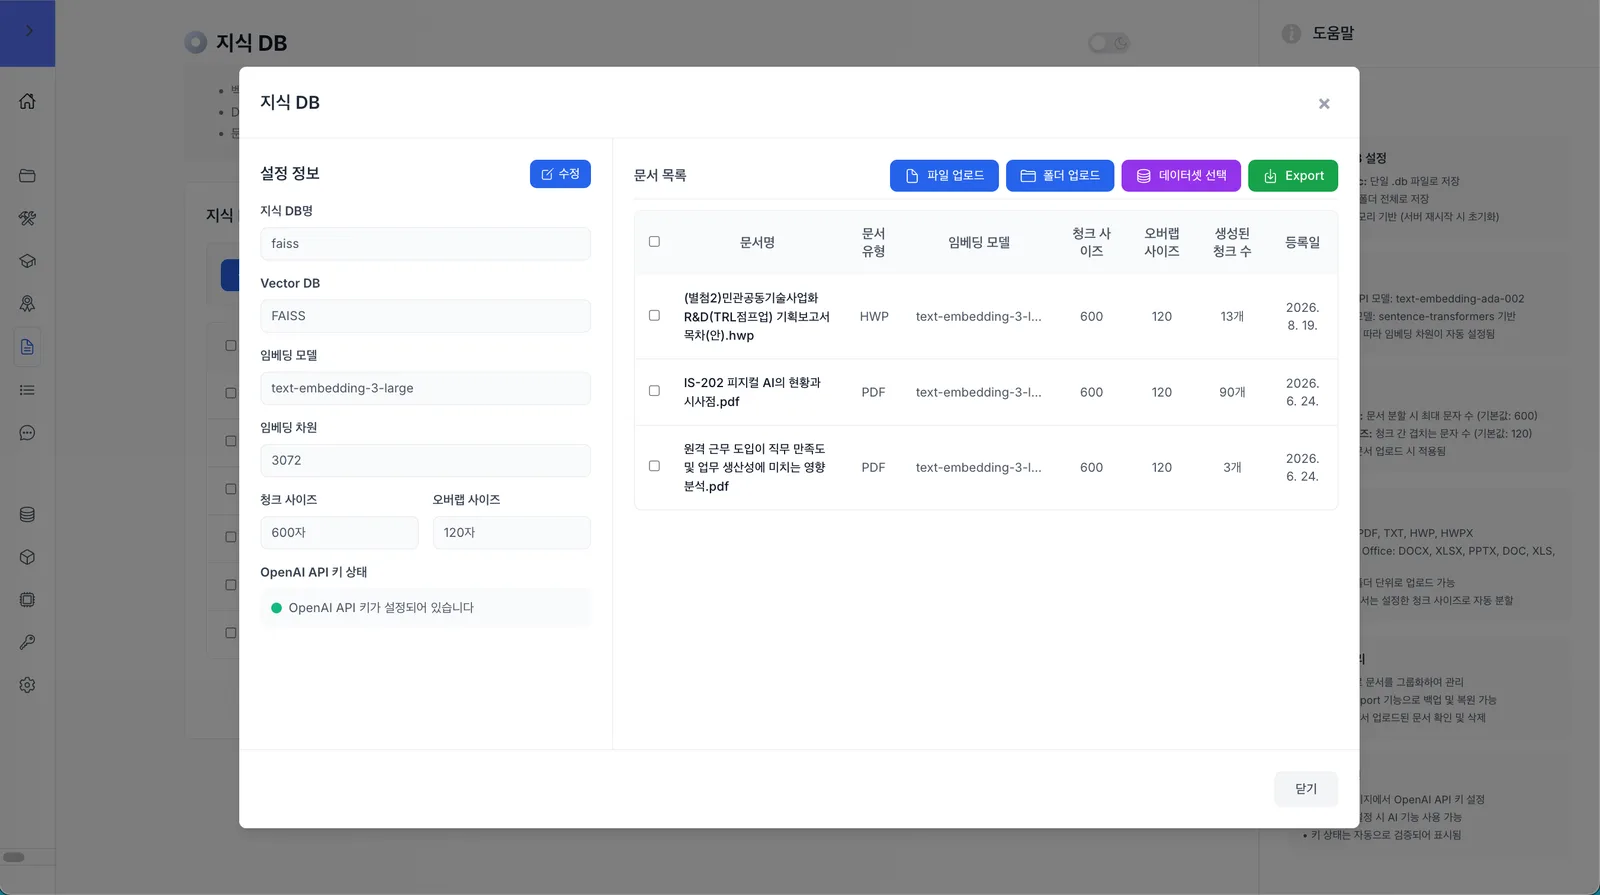
지식DB — 문서를 올리면 청크 분할과 임베딩이 자동으로 이뤄집니다. 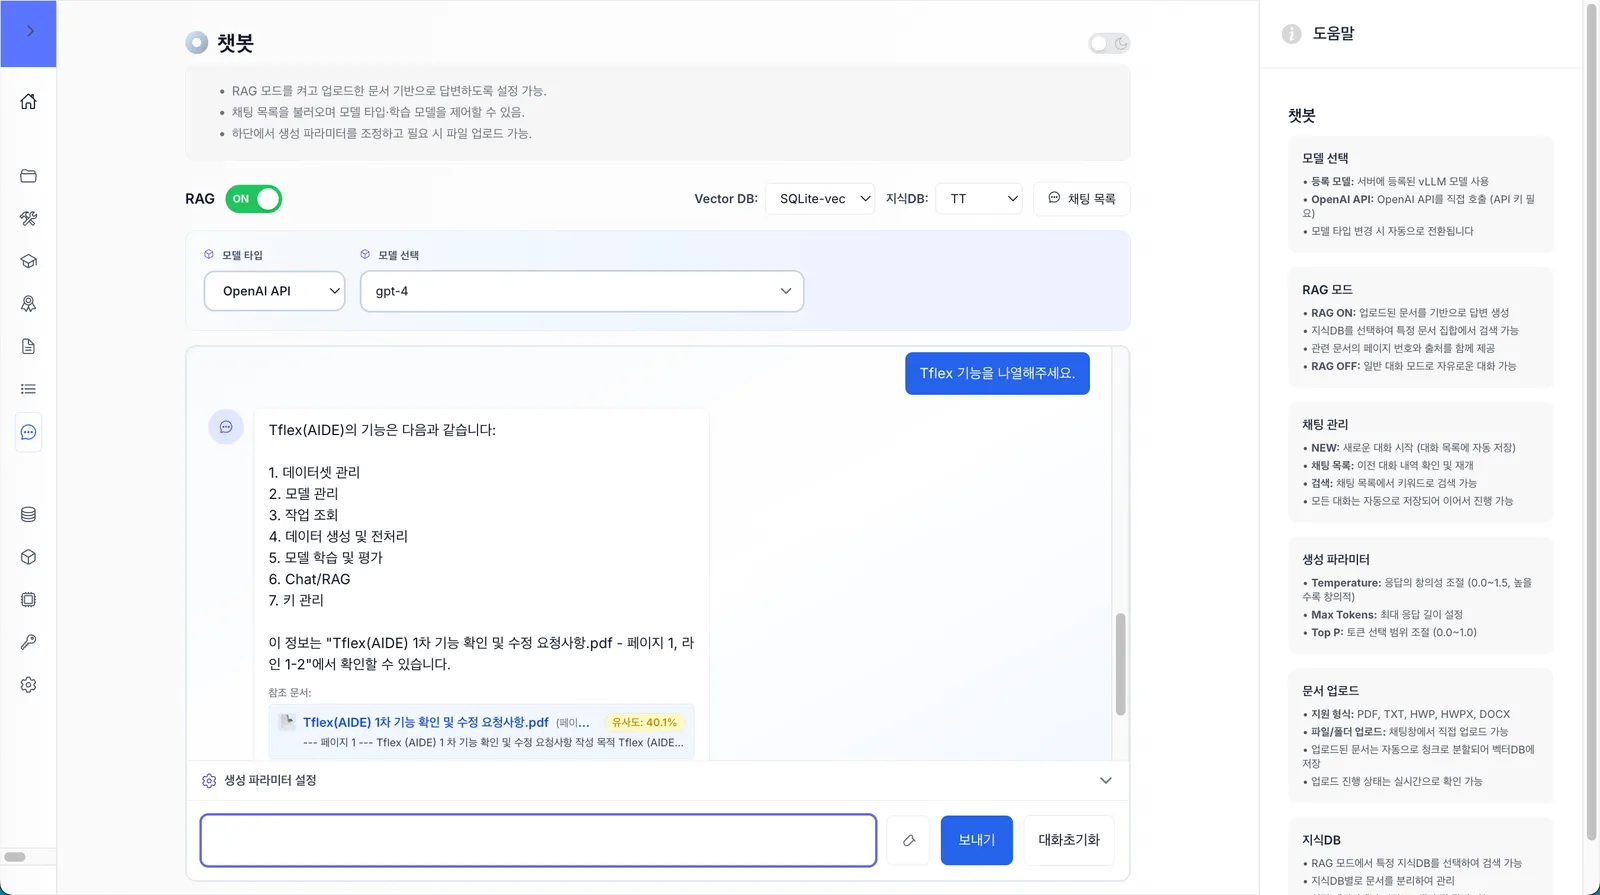
챗봇 — RAG 모드로 지식DB를 연결하고, 답변 아래 참조 문서를 표시합니다.
- 01
코드 없이 학습 방식 선택
SFT(FFT · LoRA)와 Preference(DPO · ORPO · CPO · SimPO · GRPO · PPO) 중 탭으로 고르고, 에포크 · 배치 · 학습률 등은 화면에서, 그 외 항목은 JSON으로 지정합니다.
- 02
여러 모델 동시 비교 평가
베이스 모델과 파인튜닝 모델을 나란히 놓고 KMMLU · HAERAE · CSATQA · KoBEST 등 한국어 벤치마크로 한 번에 평가합니다. 결과는 그래프와 PDF 리포트로 공유합니다.
- 03
지식DB 자동 구성
문서를 파일 또는 폴더 단위로 올리면 청크 분할과 임베딩이 자동으로 이뤄집니다. sqlite-vec · Chroma · FAISS 중 환경에 맞는 Vector DB를 고릅니다.
- 04
폐쇄망 간 지식DB 이관
암호를 설정해 지식DB를 파일로 내보내고 다른 환경에서 그대로 가져옵니다. 서버 간 이전이나 백업 시 다시 임베딩할 필요가 없습니다.
- 05
등록 모델 · 범용 API 챗봇
직접 학습한 모델 또는 범용 AI API 중 선택해 바로 챗봇으로 씁니다. 필요하면 RAG 모드로 지식DB를 연결해 문서 기반으로 답합니다.
- 06
참조 문서 출처 표시
답변 아래에 근거 문서명 · 페이지 · 유사도를 표시해, 어떤 규정을 근거로 답했는지 사용자가 직접 확인할 수 있습니다.
03 · Built-in LLM Operations
서버 · GPU · 작업을 한 화면에서
서버를 몇 대 쓰든, 여러 명이 함께 쓰든 자원과 작업, 권한을 플랫폼 안에서 관리합니다.
- 일반 LLM 구축 도구
- 일반 도구는 한 사람이 자기 서버에서 쓰는 개인 도구라, 여러 서버 · 여러 사용자 운영에는 별도 인프라가 필요합니다.
- Tflex
- MASTER / WORKER 서버 여러 대를 자동 체크리스트로 등록 · 점검하고, 사용자 권한 · API 키 · 작업 큐를 플랫폼 안에서 관리합니다.
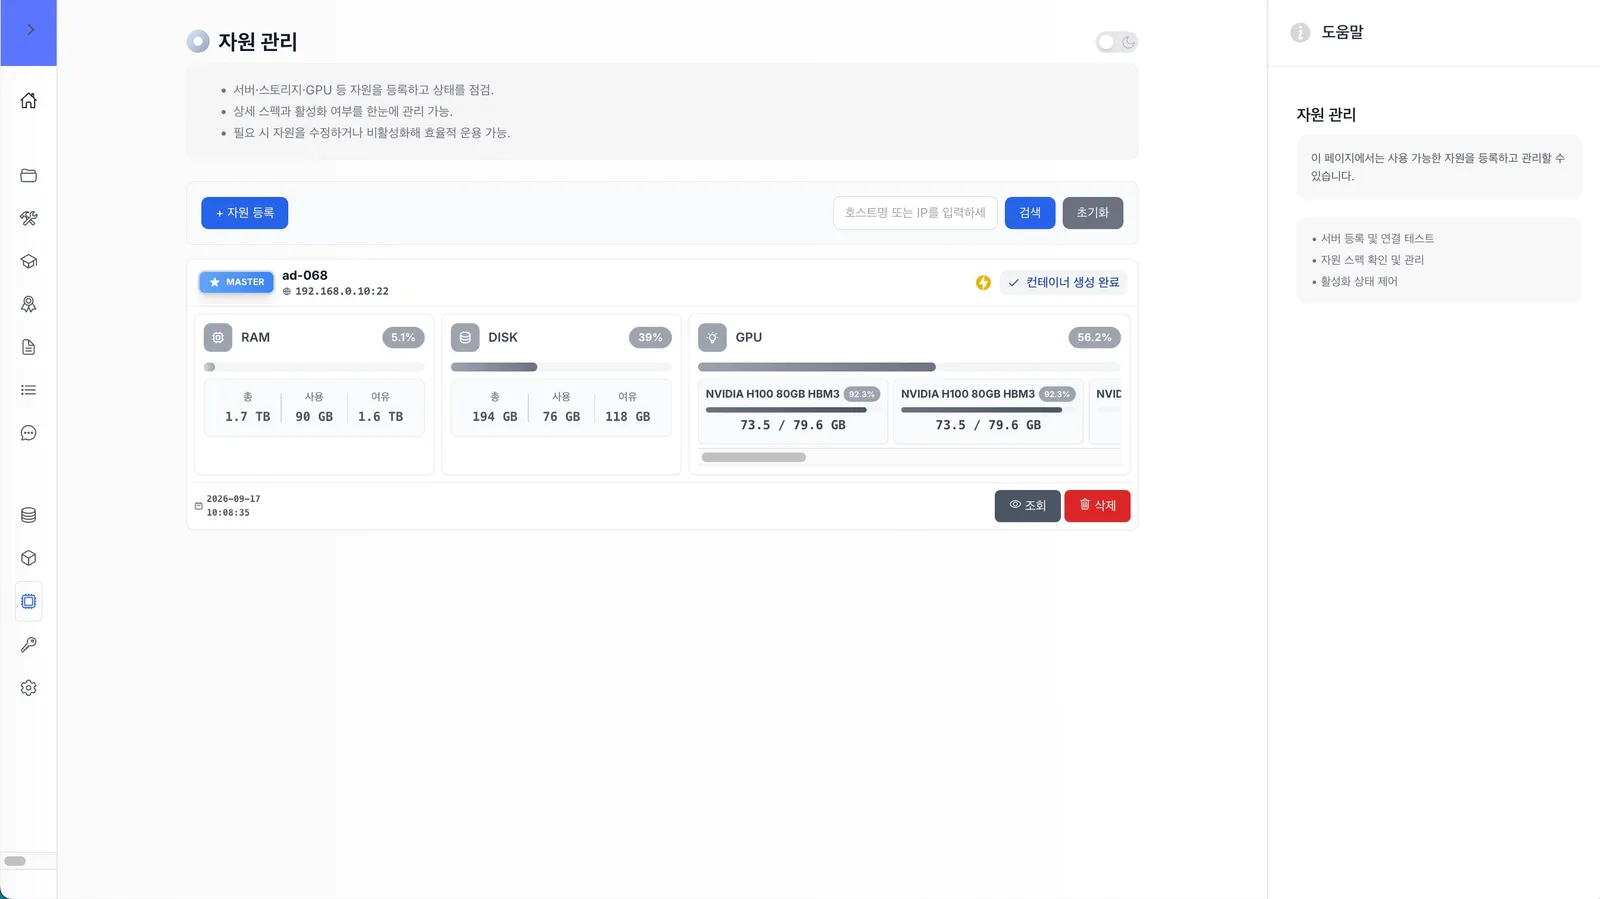
자원 관리 — 서버별 RAM · DISK · GPU 사용량을 실시간으로 확인합니다. 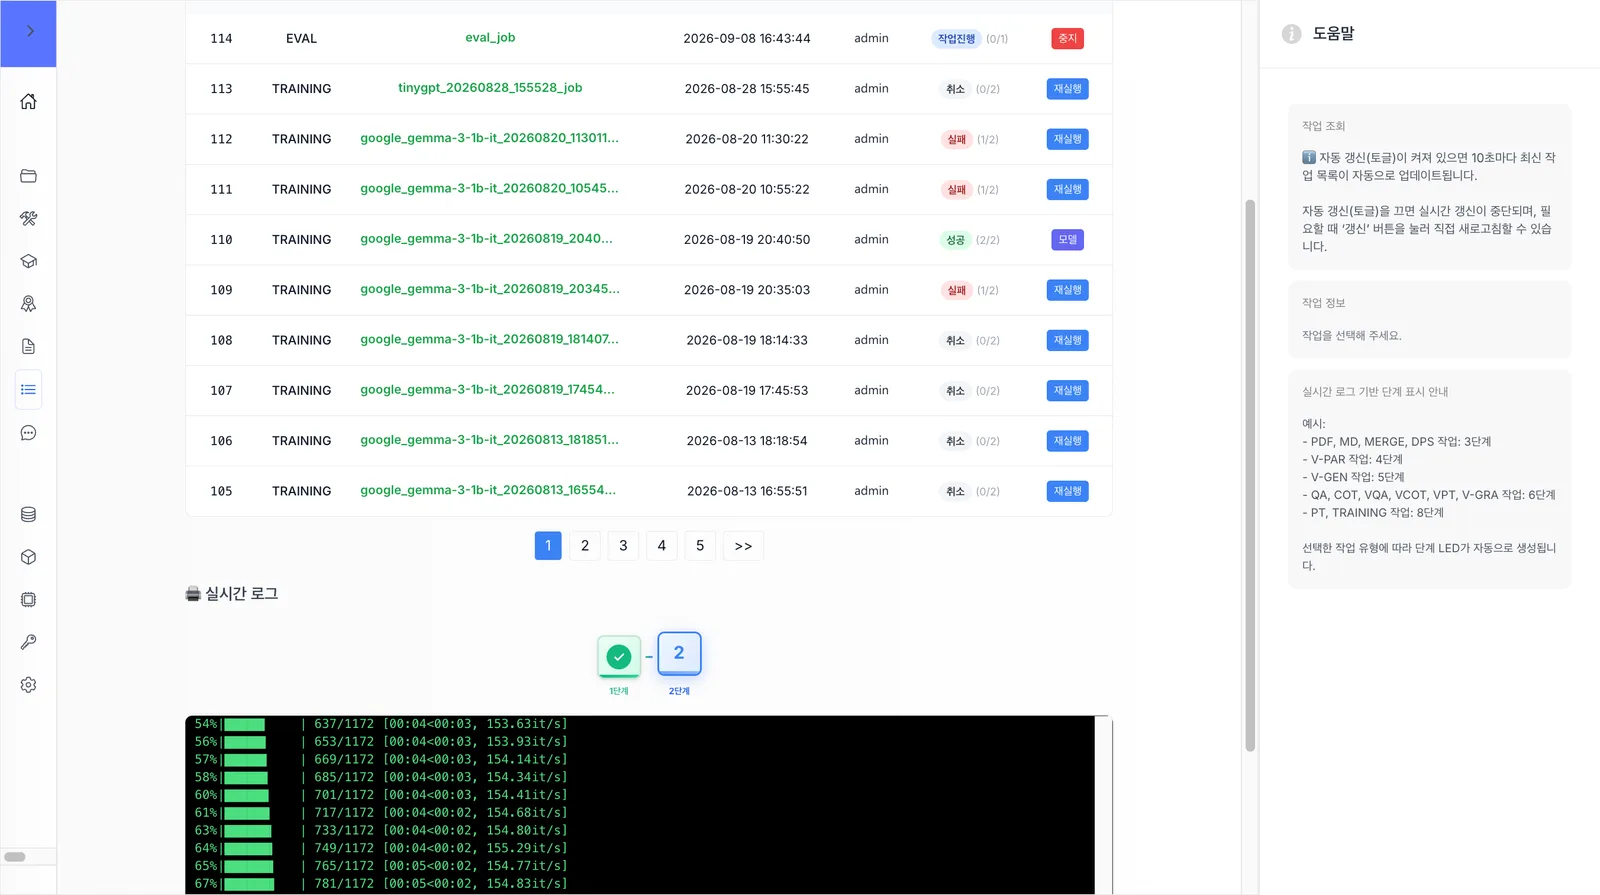
작업 조회 — 작업 큐의 상태를 확인하고 단계별 실시간 로그를 봅니다. 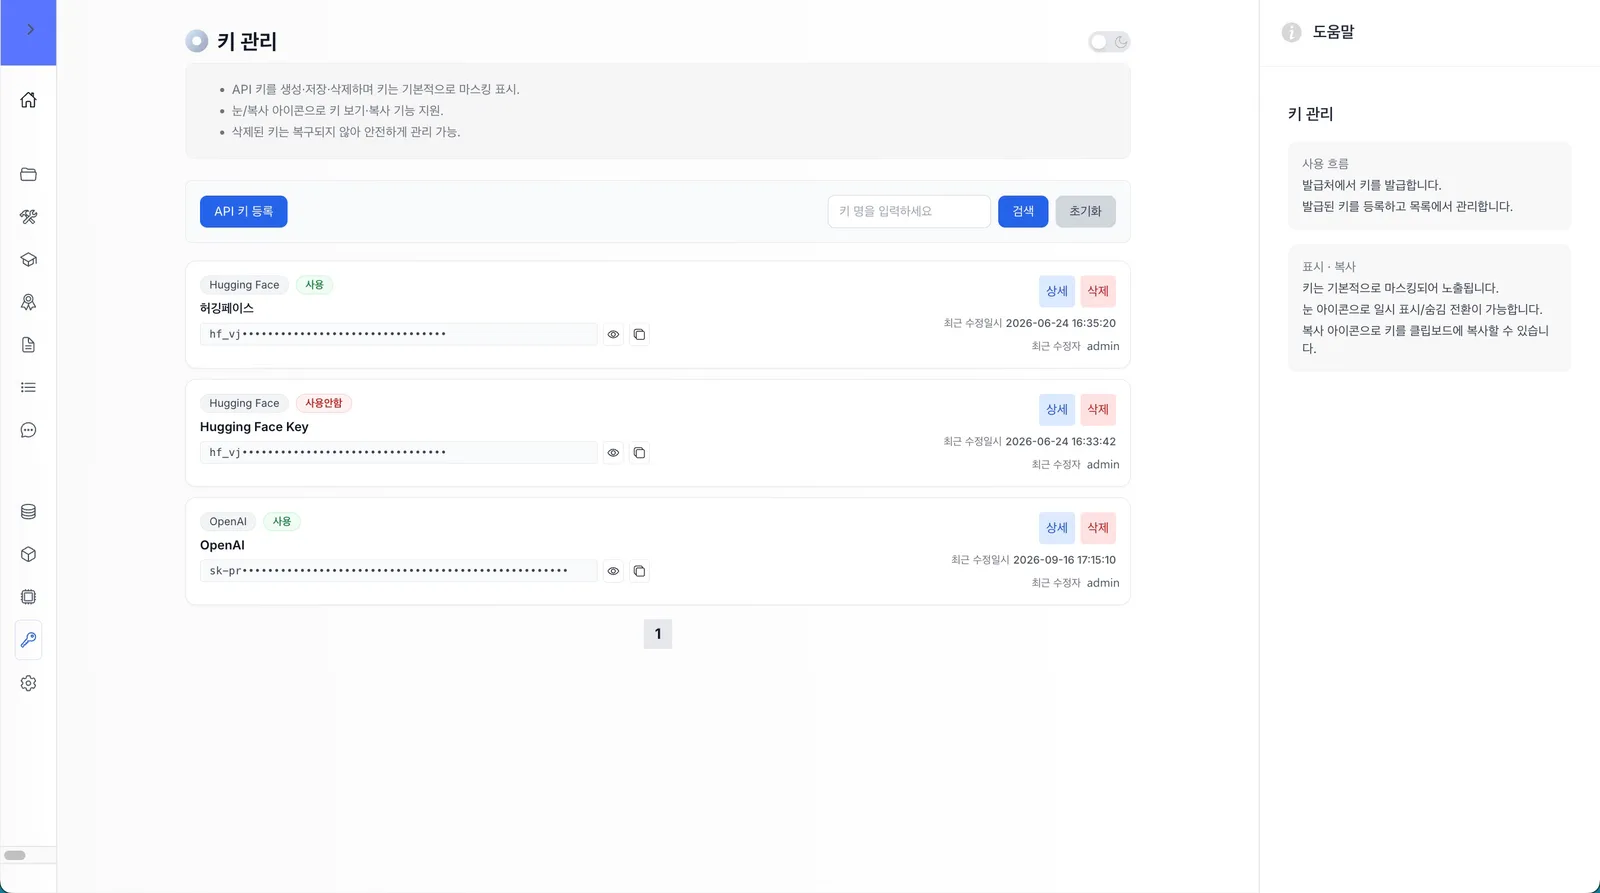
키 관리 — 외부 서비스 API 키를 마스킹된 상태로 등록 · 관리합니다.
- 01
서버 등록 자동 점검
IP · SSH 정보만 입력하면 권한 · GPU · 드라이버 · CUDA · Docker · 네트워크 · NAS · 방화벽 등 9개 항목을 자동으로 확인합니다.
- 02
RAM · DISK · GPU 실시간 게이지
서버별 총량 · 사용량 · 여유량과 GPU 카드별 사용률을 한 화면에서 보고, 학습을 어디에 걸지 판단합니다.
- 03
작업 큐와 실시간 로그
대기 · 진행 · 성공 · 실패로 작업을 거르고 순서를 바꿉니다. 진행 중 작업의 단계별 로그로 어디서 멈췄는지 바로 확인합니다.
- 04
외부 서비스 키 관리
허깅페이스 · OpenAI 등 API 키를 등록해 두면 필요한 작업에서 자동으로 쓰입니다. 키는 항상 마스킹되고 수정 이력이 남습니다.
FAQ
자주 묻는 질문
GPU 없이도 Tflex를 사용할 수 있나요?
모델 학습과 자체 모델을 이용한 서비스에는 NVIDIA GPU가 필요합니다. 외부 API 모델만 사용하는 경우 GPU 없이도 동작하지만, 이때는 데이터가 외부로 전송되고 별도의 API 사용 요금이 발생합니다.
어떤 모델을 학습시킬 수 있나요?
Safetensors 형식의 오픈 모델을 지원하며, 허깅페이스 다운로드 또는 NAS 등록으로 가져옵니다. 폐쇄망 환경에서는 보통 1~8B 규모 모델에 파인튜닝을 적용하는 방식을 많이 사용합니다.
이미지도 학습시킬 수 있나요?
도표 · 사진이 포함된 문서로 VQA(텍스트+이미지) 학습 데이터를 생성하고 학습할 수 있습니다. 이미지를 보고 질문에 답하는 모델은 만들 수 있지만, 텍스트로 새 이미지를 만드는 이미지 생성 모델은 다루지 않습니다.
서버를 여러 대로 나눠 운영할 수 있나요?
MASTER와 WORKER 구조로 서버를 등록해 여러 대를 운영할 수 있습니다. 등록 시 GPU · 드라이버 · Docker · 네트워크 등 9개 항목이 자동 점검되며, GPU는 전체 또는 개별 인덱스 단위로 서비스에 할당할 수 있습니다. GPU가 탑재된 서버만 등록할 수 있습니다.
Tflex 도입을 검토하고 계신가요?
운영 환경(GPU 서버, 폐쇄망 여부)과 활용하려는 문서 · 업무를 알려주시면, 조직에 맞는 구축 방식을 함께 정리해 드립니다.